我为什么做 EchoType:AI 英语学习产品的真实起点
最开始,我对 EchoType 的想法其实很简单。
2026 年 2 月,我写了第一份设计文档,里面列着 Listen、Speak、Read、Write 和 AI Chat。我的想法是,把听、说、读、写放进同一个产品,学习就能顺着一份材料继续下去。
现在回头看,我当时把"放在一起"和"连起来"当成了同一件事。
一篇文章可以出现在五个模块里。用户可以播放它、朗读它、照着输入一遍,最后每个页面都显示完成。可他还是可能没听懂,也没有用自己的话说过一遍。这个问题,我是在产品做出来以后才慢慢看清的。
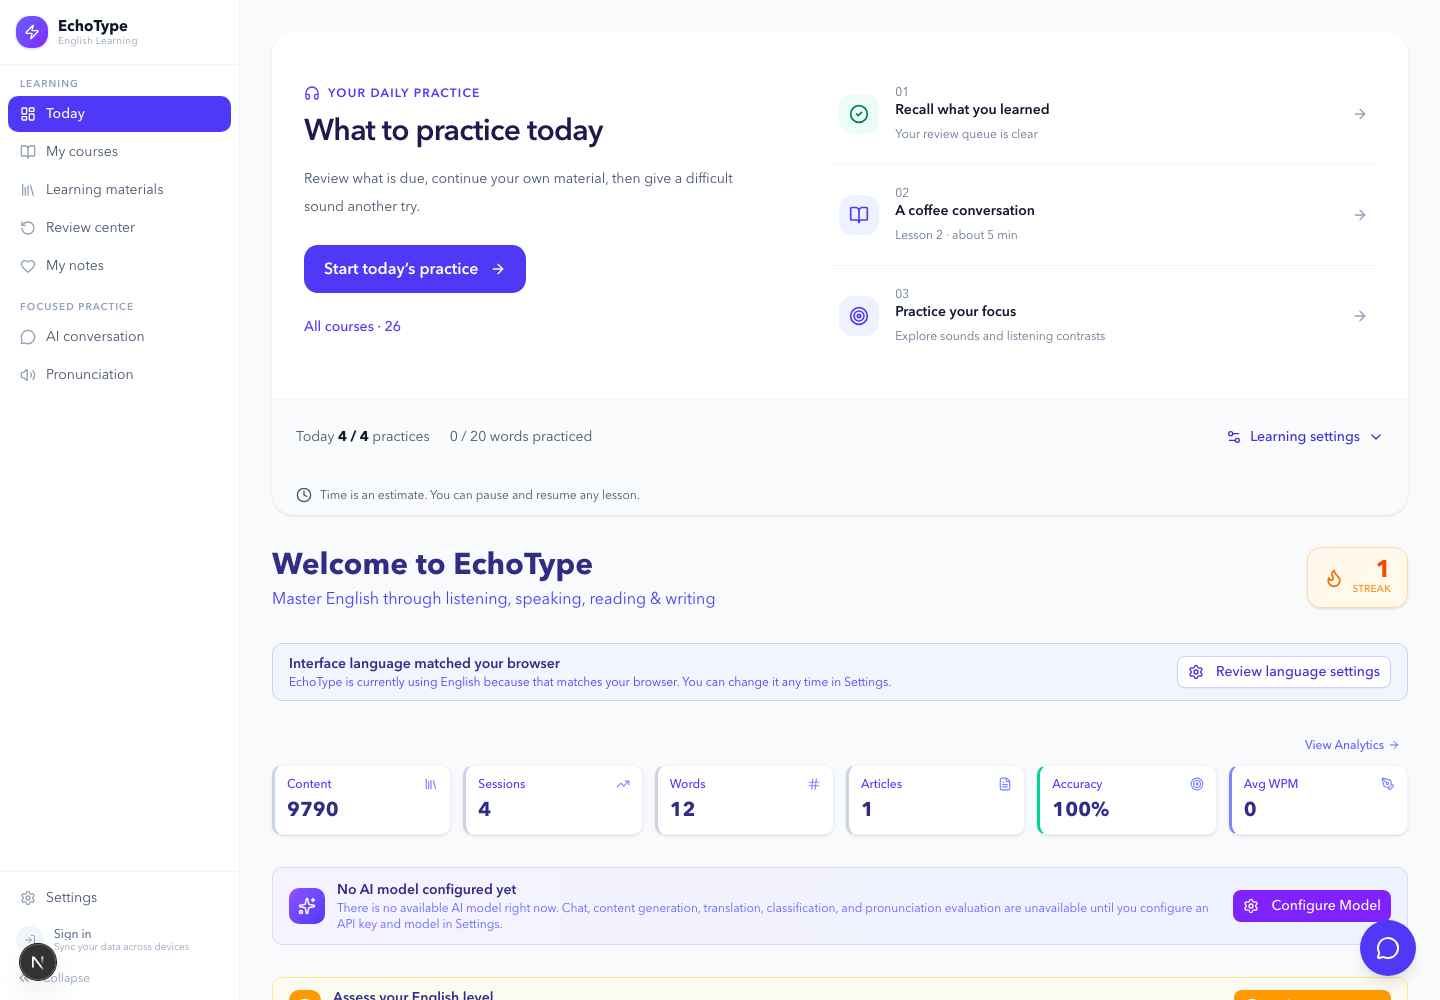
现在的今日练习页,会把复习、课程和专项训练放进同一天的安排里。
我先想解决材料到处散落的问题
学英语时,我们很容易在不同工具之间来回切换。单词放在一个应用里,听力在另一个应用里,遇到一篇想精读的文章,又要把句子复制到别处跟读或跟打。工具本身没有问题,麻烦在于材料和刚刚建立起来的上下文总是留不住。
所以 EchoType 从一开始就用了统一的内容模型。网页、YouTube、PDF、音频和手动输入的文本,最后都进入同一个内容库。文章可以拆成句子、短语和单词,再交给不同的练习模块使用。
这听起来很像一个工程师会给出的答案。确实也是。先把数据结构统一,再让几个模块共用它,逻辑上很顺。第一版很快就有了听力、朗读、输入训练和 AI 对话,看起来也已经挺完整了。
问题是,模块之间共享了内容,学习过程却没有因此自动连起来。
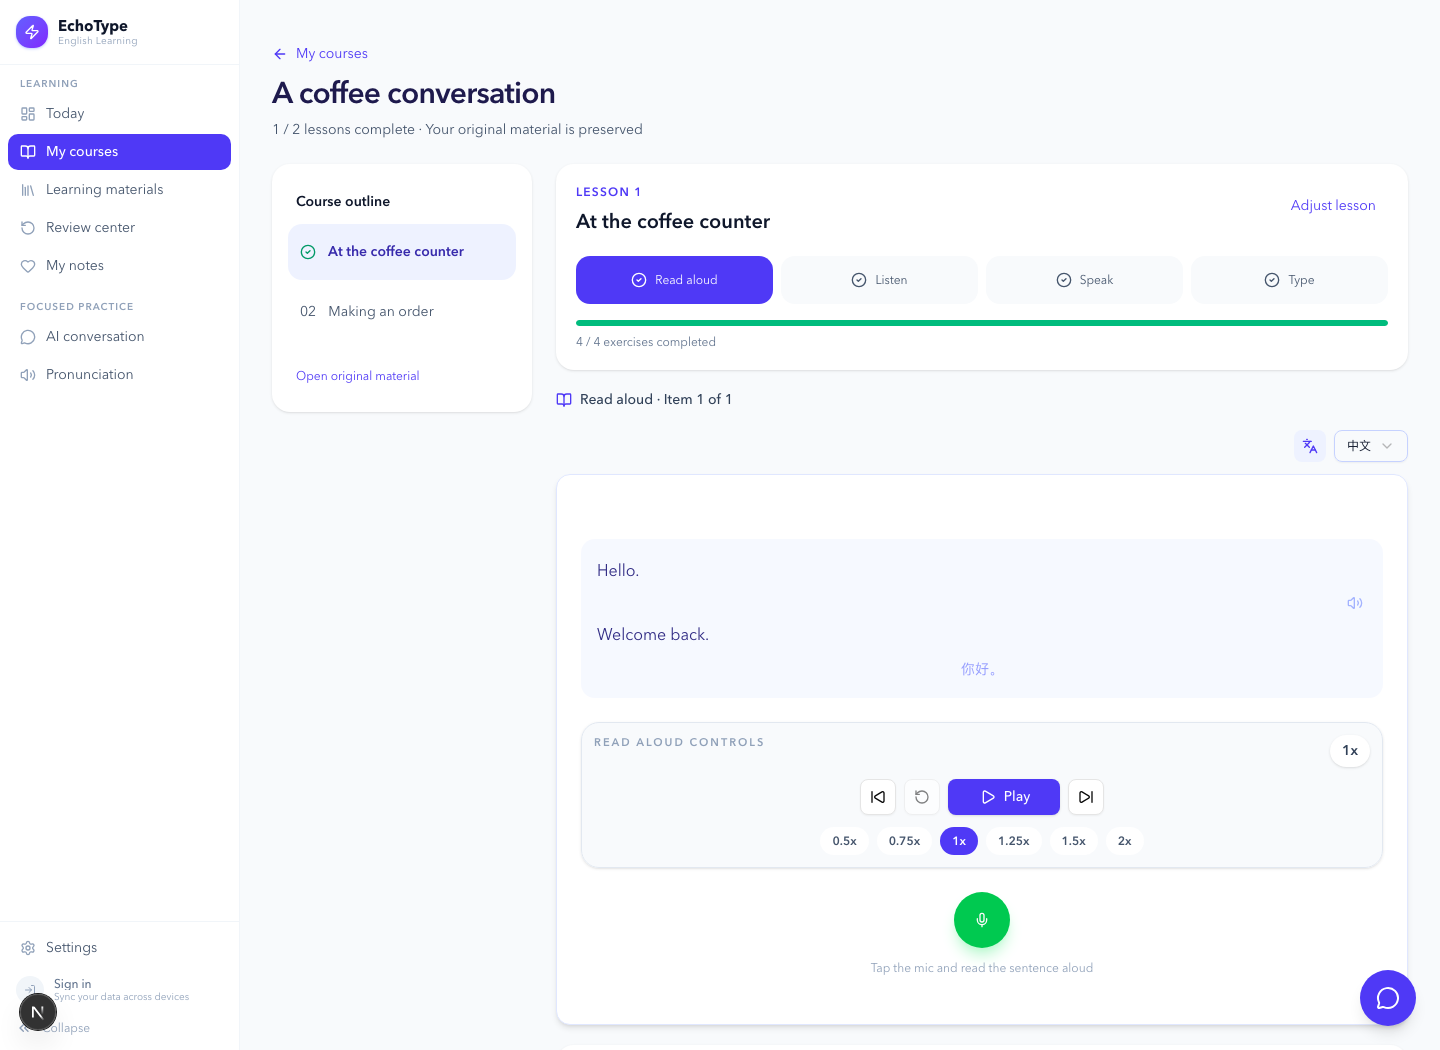
同一课里的朗读、听力、口语和输入练习,都来自原来的那份材料。
听过一遍,系统很好记录。有没有听懂,就没那么好判断了。朗读结束、输入结束、页面走完,这些都能变成一个清楚的完成状态,可它们说明不了用户掌握了多少。
做到这里,我才开始重新看最初的流程。用户应该先理解材料,再处理里面的难词、句型和发音。接下来要离开原文,用自己的话复述或写出来,然后根据反馈修改,把实际出错的部分放进复习。少了自主输出,前面几个模块做得再完整,最后还是容易停在"我好像学过"。
做着做着,我开始反复修导入
既然所有练习都从材料开始,导入失败就会把整个流程卡在第一步。
界面上只是"粘贴链接,得到正文",实际情况要麻烦得多。网页结构会变,YouTube 视频可能没有字幕,自动字幕和人工字幕的质量也不一样。网络请求会超时,文件解析完成后还可能丢掉段落、标题或时间轴。
翻项目的提交记录,会看到不少这样的改动:URL 导入失败后允许手动恢复、YouTube 字幕增加多级回退、尽量保留文本格式、限制请求次数、导入中断后可以重试。
这些工作放进产品介绍里不太起眼,却直接影响用户能不能开始第一次练习。后来我越来越愿意花时间处理这种问题。入口不可靠,后面的学习流程设计得再细也没有用。
AI 在 EchoType 里的位置也逐渐清楚了。它适合解释句子、按照当前等级生成练习、分析写作,再给口语反馈补充一些信息。浏览器语音、基础听读、输入训练和本地内容管理可以自己运行,不需要全部经过模型。
EchoType 支持多个模型服务,也允许用户填写自己的 API Key。即使没有配置模型,基础功能仍然能用。数据默认保存在本地,需要跨设备同步时再登录。
这样做会多出一些开发工作。不同模型的接口和能力不完全一样,语音、文本生成和结构化输出也得分别处理。不过,某个模型服务发生变化时,用户还可以打开自己的材料,继续做基础练习。对我来说,这个边界很重要。
后来为什么又做了桌面端
Web 版打开方便,发布也快。文件导入、本地音频和离线使用越来越多以后,浏览器的限制就开始冒出来。
2026 年 3 月,我用 Tauri 2 做了桌面端。接下来的事情比"把网页装进一个壳"琐碎得多:macOS、Windows 和 Linux 都有自己的打包、启动、更新和文件问题。Windows 路径长度、Linux AppImage、软链接、原生依赖,这些细节后来都出现在提交记录里。
桌面端让本地优先这件事更完整。用户导入的材料和练习记录先留在自己的设备上,不用为了再次打开它们而依赖在线账户。
我现在怎样理解"完成"
回头看第一版,有几个命名其实比功能走得更远。
Write 当时主要是对照原文输入。它能检查速度、准确率和拼写错误,但用户并没有真的在写一段自己的内容。Read 更接近朗读训练,阅读理解、信息定位和无提示复测都还不够。Speak 能比较转写结果和原文,文字相似度也替代不了完整的发音评价。
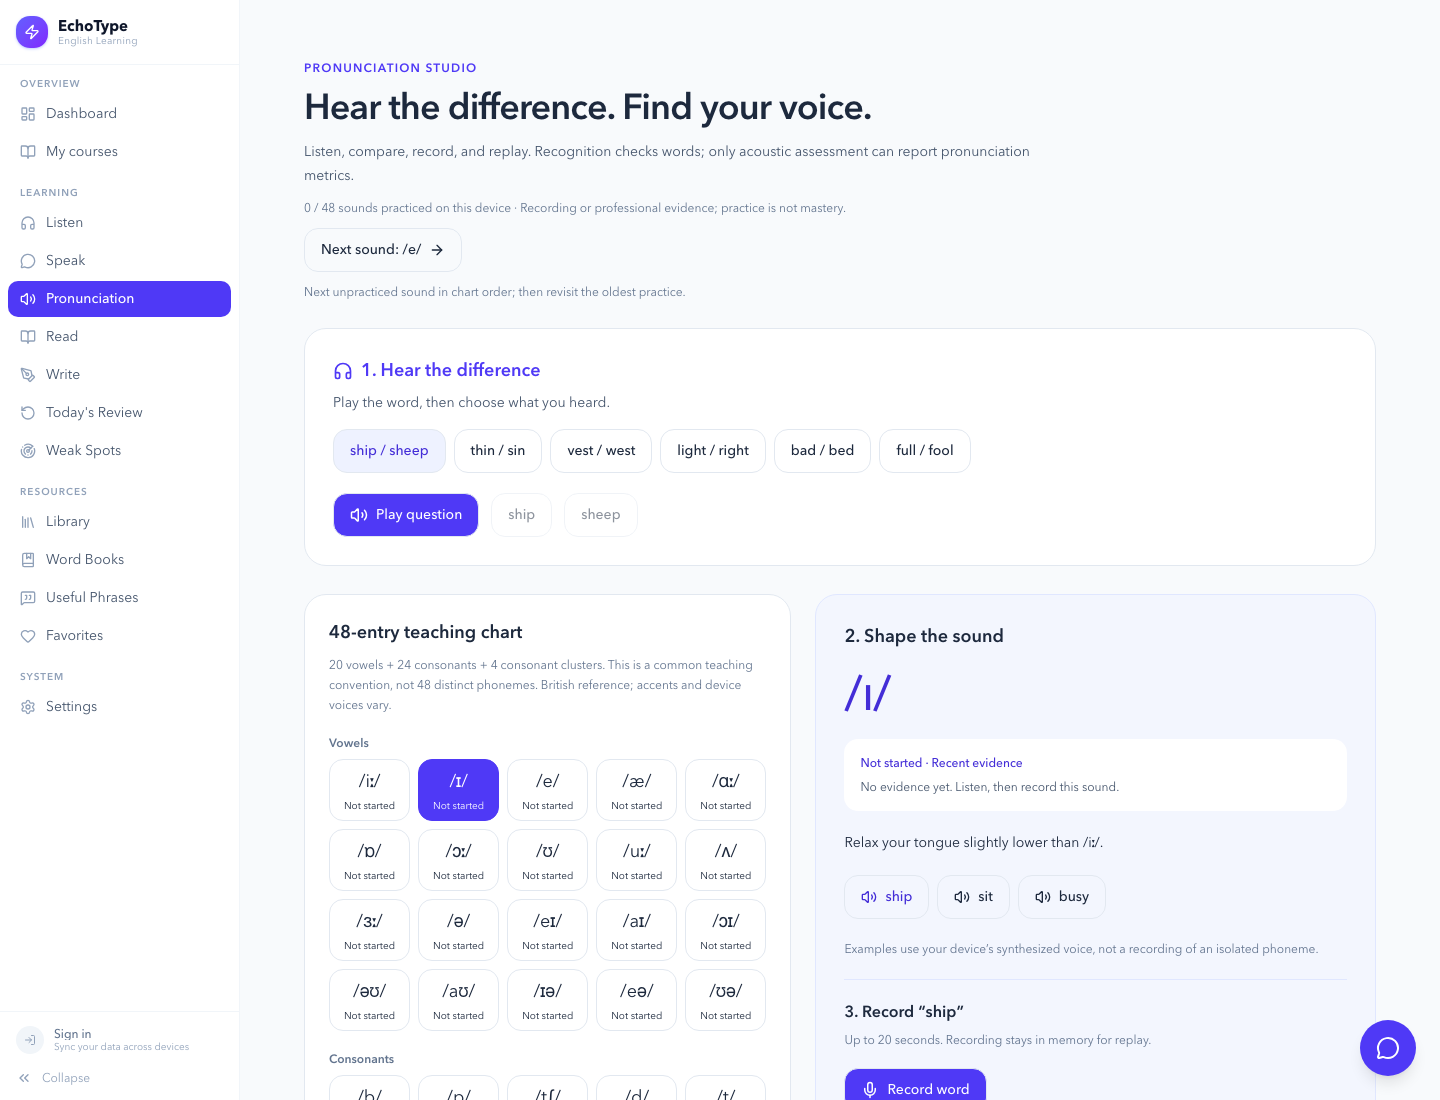
发音练习把辨音、发音提示和录音放在一起,但一次录音仍然不能直接等同于掌握。
我现在会把"完成"和"掌握"分开。完成表示用户做完了一个有效任务,掌握则需要更多证据。听、说、读、写也不能共用一个结论。一个单词看到时认识,听到时可能反应不过来,到了对话里又可能用不出来。
这些问题到现在也没有全部解决。EchoType 还在补阅读理解、自主写作、材料处理、同步可靠性和跨端数据恢复。有些地方做着做着,我会发现自己一开始问错了问题,只能回头改。
现在介绍 EchoType,我可以列出一长串功能:网页和 YouTube 导入、文件与音频处理、听读、口语、输入练习、CEFR 等级评估、AI 导师、发音反馈、间隔复习,还有 macOS、Windows 和 Linux 桌面版。
不过这张清单解释不了我为什么还在做它。
我在意的还是最开始那件事:一份用户确实想学的内容,能不能一直留在同一个学习过程中,直到他理解它,也试着用自己的语言表达出来。
EchoType 还没有把这件事做完整。它只是比第一份设计文档更接近这个问题了。
你可以在 echo-type.app 体验 EchoType,也可以在 GitHub 查看代码和提交记录。